What Does Graph Structure Add to Biological Representation Learning?
INTRODUCTION
생물학 데이터로 표현학습(representation learning)을 할 때는 자연어나 이미지와는 다른 두 가지 원리적 한계에 부딪힌다.
첫째, 측정의 불확실성이다. 제한된 sequencing depth 아래에서 개별 세포, 개별 genomic locus의 발현량은 오차 없이 측정되지 않는다. 특히 단일세포 데이터에서는 실제 발현이 있음에도 0으로 관측되는 dropout이 흔하며, 관측값 자체가 희소하고 노이즈가 크다. 데이터의 양(표본과 이웃 관측)이 많아질수록 완화되는 종류의 문제이다.
둘째, 관측 데이터의 인과적 비식별성이다. LLM에서는 사전학습 목적함수인 다음 토큰 예측을 잘 하는 것이 곧 문맥을 이해하고 언어를 잘 다루는 것과 거의 같은 과제이다. 그러나 생물학에서는 사전학습 과제와 우리가 궁극적으로 묻고 싶은 과제 사이의 정합성이 보장되지 않는다. 마스킹된 발현값이나 서열을 복원하는 과제는 관측 분포 안의 연관 구조를 배우는 일인 반면, “이 유전자를 knock out하면 무슨 일이 일어나는가”는 분포 바깥의 개입(intervention)에 관한 질문이다. 관측 분포만으로는 동일한 조건부 독립 구조를 갖는 서로 다른 인과 구조, 즉 같은 마르코프 동치류(Markov equivalence class)에 속하는 구조들을 구별할 수 없다. 이 한계는 첫째와 달리 표본 수를 늘려도 양으로 보상되지 않는다.
이 글에서는 그래프 구조가 생물학 데이터의 어떤 문제에, 어떤 가정을 통해 답하는지를 살펴본다.
귀납적 편향으로서의 그래프
An inductive bias allows a learning algorithm to prioritize one solution (or interpretation) over another, independent of the observed data.
Battaglia et al. (2018)
데이터가 여러 개의 답을 동시에 허용할 때, 그중 하나를 고르게 만드는 사전 믿음이 귀납적 편향(inductive bias)이다. 앞서 본 것처럼 생물학 데이터에 원리적인 한계가 있다면, 남는 선택지는 생물학적으로 타당한 가정을 명시적인 편향으로 아키텍처에 심는 것이다.
그래프는 개체와 관계를 명료화하고, 정보가 전달되는 경로와 여러 개체가 공유하는 계산 규칙을 구조화함으로써 이러한 가정을 부여한다. Battaglia 등(2018)의 정리를 빌리면, graph network가 부과하는 구조적 가정은 크게 네 가지이다.
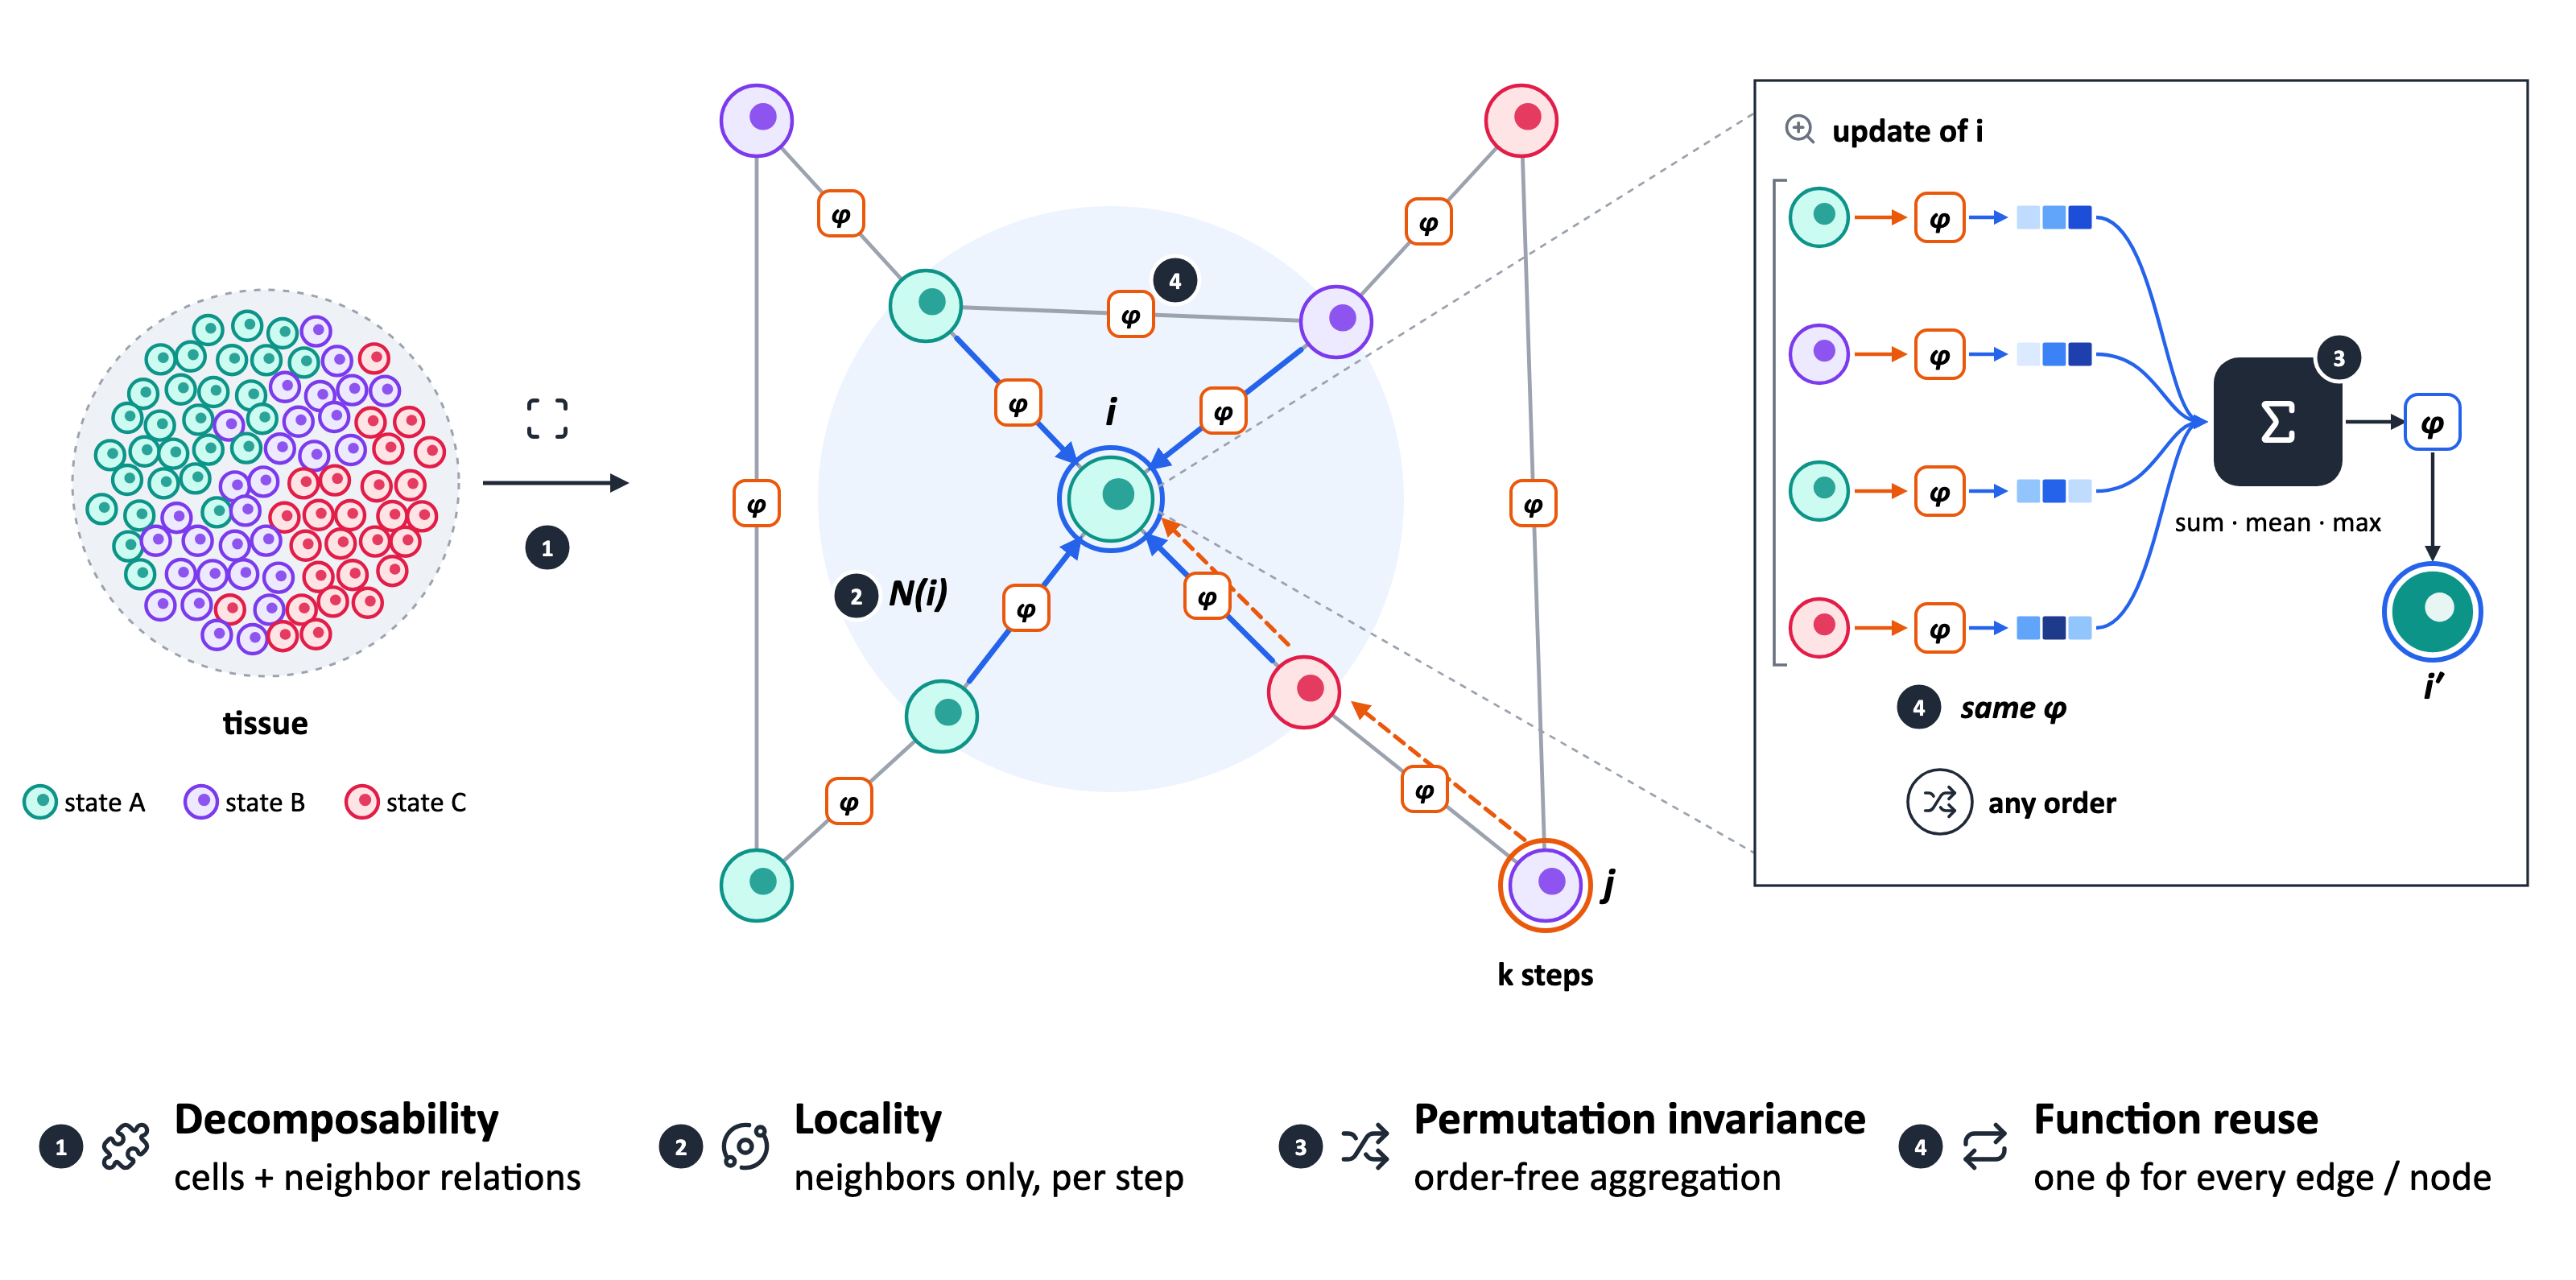
첫째, 세계는 개체로 분해될 수 있다 (decomposability). 그래프는 입력 자체를 (u, V, E)라는 분해된 자료구조로 받는다(u는 전역 속성, V는 노드 집합, E는 엣지 집합). 아키텍처가 강제하는 이 형식은, 세계가 그 내부가 아무리 복잡하더라도 이산적인 단위들과 그 사이의 관계로 분해된다는 존재론적 가정을 담고 있다. 이 가정에서는, 현상을 개체의 속성과 개체 사이의 관계로 표현하는 것이 과제 해결에 유용함을 전제한다.
둘째, 상호작용은 국소적이다 (locality). 한 시점에 어떤 노드에 직접 영향을 주는 것은 엣지로 연결된 이웃뿐이며, 멀리 있는 노드의 영향은 반드시 중간 단계를 거쳐 매개된다. 이 개념은 원격 작용(action at a distance)을 부정하는 근대 물리학의 장(field) 개념과 닮아 있다. 태양이 지구를 당기는 것은 원거리 상호작용이 아니라, 태양이 주변 시공간을 변형시키고 그 변형이 공간을 통해 국소적으로 전파되어 지구에 도달하는 과정으로 기술된다. 이 가정은 학습해야 할 상호작용의 공간을 극적으로 줄인다. 연결된 쌍 수준의 국소 규칙만 배우고, 전역적 결론은 그 규칙의 반복적 조합(message passing)으로 얻기 때문이다. (다만 전역 속성을 공유하거나 모든 노드 쌍을 연결하는 구성에서는 정보 전달의 범위가 달라진다.)
셋째, 관계에는 내재적 순서가 없다 (permutation invariance). 노드와 엣지를 어떤 순서로 나열하든 그래프 수준의 출력은 같아야 하고, 노드 수준의 출력은 나열 순서를 그대로 따라 바뀌어야 한다. 이는 aggregation 함수를 순열에 불변이고 가변 개수의 입력을 받을 수 있게(합, 평균, 최대 등) 정의함으로써 강제된다. 이 가정이 없다면 모델은 n개 노드의 n!가지 나열 순서라는, 세계를 벡터화하는 과정에서 사람이 임의로 부과한 무의미한 변인에 대한 불변성까지 데이터로부터 학습해야 한다. 대칭성을 아키텍처에 하드코딩함으로써 그래프는 이 비용을 없앤다.
넷째, 규칙은 보편적이다 (function reuse). 엣지 업데이트 함수는 모든 엣지에, 노드 업데이트 함수는 모든 노드에 동일하게 적용된다. 상호작용의 법칙이 “어느 개체 쌍인가”와 무관하게 성립한다는 가정으로, CNN의 kernel이 위치에 대해, RNN의 cell이 시점에 대해 부과하는 가정과 맥을 같이 한다. 따라서 모델의 가설 공간은 “개체 수와 무관하게 정의되는 함수”로 제한되고, 학습 때 보지 못한 개체나 다른 크기의 그래프에도 같은 함수를 그대로 적용할 수 있다. 새로운 개체에서도 같은 규칙이 성립한다는 보편성 가정이 실제로 참일 때에만 이 일반화는 옳다.
Examples
이 네 가지 가정이 생물학 데이터 위에서 어떻게 작동하는지 보자.
공간전사체 분석에서 SpaGCN은 spot의 물리적 좌표(x, y)에 histology 이미지에서 얻은 값을 세 번째 축(z)으로 더해 유클리드 거리를 계산하고, 그 거리를 가우시안 커널에 통과시켜 엣지 가중치로 삼는다. 이 그래프 위에서 graph convolution을 수행한다는 것은 “물리적으로 가깝고 조직학적으로 닮은 spot은 비슷한 발현 상태에 있을 것”이라는 가정을 전제하는 것이다. 여기서 노드를 spot으로 정의한 것은 첫째 가정, 어떤 spot을 이웃으로 삼을지는 둘째 가정, 모든 spot 쌍에 같은 커널과 같은 convolution 가중치를 쓰는 것은 넷째 가정에 해당한다.
scGNN이 세포 간 유사도로 cell-cell 그래프를 만들고 그 위에서 graph autoencoder로 imputation을 수행하여 dropout에 대응하는 것도 같은 논리이다. 어떤 세포에서 0으로 관측된 유전자가 유사한 이웃 세포들에서는 발현되어 있다면, 그 0은 생물학적 부재가 아니라 측정의 실패일 가능성이 높다고 보는 것이다.
두 사례에서 그래프는 관측치 사이의 유사성에 관한 가정을 부여함으로써, 이미 있는 정보를 어디까지 공유해도 좋은지에 대한 규칙을 제공한다. 관련된 관측 사이에서 통계적 강도를 빌려오는(borrowing strength) 것은, 제한된 측정으로부터 생물학적 상태를 더 안정적으로 추정하는 방법이다. 이러한 그래프의 관계적 편향은 처음에 제시한 두 한계 가운데 첫 번째, 측정의 불확실성을 일부 해소한다. 다만 이 효과는 연결된 관측 사이에 실제로 공유할 수 있는 생물학적으로 타당한 신호가 있다는 가정에 전적으로 의존한다.
Limitations
유사한 이웃의 정보는 추정을 안정화하지만, 잘못 연결된 이웃의 정보는 보존해야 할 실제 차이를 지울 우려도 있다. 희소한 세포 유형이 다수 유형의 이웃에 섞여 평균화되거나, 조직 경계에서의 급격한 발현 변화가 매끄럽게 뭉개지는 over-smoothing이 그 예시이다.
순환성의 문제도 짚어야 할 부분이다. scGNN의 cell-cell 그래프는 imputation하려는 노이즈 섞인 발현값 자체로부터 만들어지고, SpaGCN의 그래프도 “조직학적으로 닮았다”는 판단을 이미지 픽셀 자체로 수행하므로 사전 믿음이 상당 부분 외부가 아닌, 데이터 안에서 추정된다. 이러한 순환성은 초기 오차를 증폭하여 잘못된 연결을 강화할 수 있다.
따라서 그래프를 구성할 때는 어떤 관측을 연결할 것인지 뿐 아니라, 그 연결이 어떤 근거에서 온 것이고 그 연결을 통해 어떤 정보를 어디까지 공유해도 되는지를 함께 따져야 한다. 좋은 그래프는 관측들이 공유하는 신호를 모으면서 분석에 중요한 차이를 보존해야 한다.
관측치 간 정보 공유는 이미 관측된 분포 안에서 추정을 안정화할 뿐, 그 분포가 어떤 개입 아래에서 어떻게 바뀔지는 설명할 수 없다. 그러므로 그래프 구조는 처음에 제시한 두 문제 중 두 번째, 관측 데이터의 인과적 비식별성을 해소하지 못한다.
이 문제에 답하려면 “이미 있는 정보 사이의 연결”이 아니라 “관측으로는 알 수 없는 빈 정보”를 외부에서 부여하는, 다른 종류의 가정이 필요하다. 후속 글에서는 이에 대해 이야기해보고자 한다.
참고문헌
- Mitchell, T. M. (1980). The need for biases in learning generalizations. Rutgers University, Tech. Rep. CBM-TR-117.
- Battaglia, P. W., et al. (2018). Relational inductive biases, deep learning, and graph networks. arXiv:1806.01261.
- Hu, J., et al. (2021). SpaGCN: Integrating gene expression, spatial location and histology to identify spatial domains and spatially variable genes by graph convolutional network. Nature Methods, 18, 1342–1351.
- Wang, J., et al. (2021). scGNN is a novel graph neural network framework for single-cell RNA-Seq analyses. Nature Communications, 12, 1882.
댓글남기기